
Beispiele / 06
Wenn das Ergebnis kein Messwert ist: Schweißnähte mit ordinaler und nominaler Zielgröße
Nicht jede Zielgröße ist eine Zahl. Eine Schweißnaht wird angesehen und eingestuft: Wie viele Spritzer liegen daneben, und welcher Fehler steckt im Schliffbild? Die erste Antwort hat eine Reihenfolge, die zweite nicht. Hier werden 81 Proben bei drei Einstellgrößen geschweißt, die Spritzer mit einem ordinalen Modell und der Nahtfehler mit einem multinomialen Modell ausgewertet, und am Ende steht die Einstellung, bei der eine gute Naht am wahrscheinlichsten ist.
- Versuchsplan
- 3³-Vollfaktorplan, je Einstellung 3 Proben = 81
- Modelle
- proportionale Odds (ordinal), multinomiales Logit
- Faktoren
- Strom, Vorschub, Schutzgas
- Zielgrößen
- 2 mit je 4 Kategorien, Bestätigung mit 24 Proben
Die Urteile sind simuliert. Sie stammen aus zwei Modellen, die wir selbst festgelegt haben — für jede Probe wird aus den wahren Wahrscheinlichkeiten eine Kategorie gezogen. So lässt sich am Ende prüfen, ob die Auswertung findet, was wirklich drinsteckt. Alle Tabellen und Diagramme sind mit DoEStat gerechnet und gezeichnet.
Schritt 1 / Aufgabe
Eine Naht, zwei Urteile
Für eine Kehlnaht an Baustahl soll eine MAG-Einstellung gefunden werden, die möglichst oft eine fehlerfreie Naht mit wenig Spritzern liefert. Frei sind drei Größen:
| Faktor | Einheit | niedrig | Mitte | hoch |
|---|---|---|---|---|
| Schweißstrom | A | 160 | 200 | 240 |
| Vorschub | cm/min | 30 | 45 | 60 |
| Schutzgasmenge | l/min | 8 | 14 | 20 |
Jede Probe wird zweimal beurteilt: die Spritzer mit dem Auge auf einer vierstufigen Skala, der Nahtfehler im Schliffbild. Beide Zielgrößen haben vier Kategorien — aber nicht von derselben Art:
| Zielgröße | Art | Kategorien |
|---|---|---|
| Spritzer | ordinal (geordnet) | keine < wenige < mäßig < viele |
| Nahtfehler | nominal (ohne Reihenfolge) | keiner · Poren · Bindefehler · Einbrandkerbe |
„Wenige“ Spritzer liegen zwischen „keinen“ und „mäßig“ — die Stufen sind geordnet, aber ihre Abstände sind nicht bekannt; aus „mäßig“ wird nicht „doppelt so viele wie wenige“. Die Nahtfehler dagegen sind nur benannt: Poren sind nicht „mehr“ als ein Bindefehler, sie haben eine andere Ursache. Diese Unterscheidung entscheidet über das Modell. In DoEStat legt man sie in der Definition der Zielgröße fest: Stufen auflisten, Häkchen „geordnet“ setzen oder nicht.
Auf diese Daten eine Regression zu legen, als wären die Kategorien die Zahlen 1 bis 4, wäre in beiden Fällen falsch: Beim Nahtfehler gibt es keine Reihenfolge, beim Spritzer keine gleichen Abstände. Was sich modellieren lässt, ist die Wahrscheinlichkeit jeder Kategorie in Abhängigkeit von der Einstellung.
Schritt 2 / Planung
Wie viele Proben braucht ein Urteil?
Eine Kategorie trägt weniger Information als ein Messwert. Eine einzelne Probe sagt nur „Poren“ oder „keine Poren“ — die Wahrscheinlichkeit dahinter erfährt man erst aus vielen. Ein Vollfaktorplan mit drei Stufen je Faktor hat 27 Einstellungen; die Frage ist, wie oft jede geschweißt werden muss.
Die Tabelle zeigt, wie oft die Auswertung brauchbar ist, wenn man die ganze Studie hundertmal aus den wahren Modellen zieht. „Auswertbar“ heißt: Das Modell konvergiert, jede Kategorie kommt vor, und keine Schätzung läuft ins Unendliche.
| Proben je Einstellung | Proben gesamt | Spritzer (ordinal): auswertbar | Nahtfehler (nominal): auswertbar |
|---|---|---|---|
| 1 | 27 | 99 % | 24 % |
| 2 | 54 | 100 % | 81 % |
| 3 | 81 | 100 % | 96 % |
| 4 | 108 | 100 % | 97 % |
Das ordinale Modell ist genügsam — es schätzt eine Steigung je Faktor, gleich für alle Stufen. Das nominale ist es nicht: Es schätzt für jeden der drei Fehler eigene Steigungen, zwölf Parameter statt sechs. Mit einer Probe je Einstellung ist es in drei von vier Studien nicht auswertbar, mit zwei noch in einer von fünf. Ab drei Proben je Einstellung sind es 96 %, und eine vierte bringt kaum noch etwas. Gewählt sind deshalb 81 Proben.
Was „ins Unendliche laufen“ heißt, ist Trennung: Kommt ein seltener Fehler bei einer Gruppe von Einstellungen nie vor, lässt sich seine Wahrscheinlichkeit dort beliebig nahe an null rücken, und die Schätzung wächst ohne Grenze. DoEStat meldet das in der Auswertung („Trennung vermutet“). Das Problem wird mit jedem zusätzlichen Term größer — ein quadratischer Schutzgas-Term, der in einem Plan mit drei Stufen naheliegt, lässt in derselben Simulation bei 81 Proben nur 45 von 100 nominalen Auswertungen brauchbar, statt 96. Das Modell hier hat deshalb nur Haupteffekte.
Diese Planungsrechnung macht das Beispiel selbst, indem es die Studie aus den wahren Modellen wiederholt. Die Teststärke-Analyse in DoEStat deckt numerische und binomiale Zielgrößen ab, kategoriale mit mehr als zwei Stufen nicht.
Schritt 3 / Versuche
81 Proben, zweimal beurteilt
Die 81 Proben werden in zufälliger Reihenfolge geschweißt. Von ihnen sind nur 22 gut im Sinn der Aufgabe — kein Nahtfehler und höchstens wenige Spritzer. Ausgezählt nach den Stufen jedes Faktors zeigt sich schon vor jedem Modell, wohin es geht:
| Einstellung | keiner | Poren | Bindefehler | Einbrandkerbe |
|---|---|---|---|---|
| Schweißstrom 160 A | 10 | 4 | 13 | 0 |
| Schweißstrom 200 A | 14 | 4 | 7 | 2 |
| Schweißstrom 240 A | 10 | 5 | 0 | 12 |
| Vorschub 30 cm/min | 16 | 8 | 1 | 2 |
| Vorschub 45 cm/min | 12 | 3 | 7 | 5 |
| Vorschub 60 cm/min | 6 | 2 | 12 | 7 |
| Schutzgasmenge 8 l/min | 9 | 9 | 6 | 3 |
| Schutzgasmenge 14 l/min | 11 | 3 | 7 | 6 |
| Schutzgasmenge 20 l/min | 14 | 1 | 7 | 5 |
Bindefehler häufen sich bei niedrigem Strom und schnellem Vorschub — zu wenig Wärme, die Naht verbindet sich nicht mit dem Grundwerkstoff. Einbrandkerben kommen bei hohem Strom. Poren hängen am Schutzgas: Bei 8 l/min sind sie häufig, bei 20 l/min selten.
| Einstellung | keine | wenige | mäßig | viele |
|---|---|---|---|---|
| Schweißstrom 160 A | 16 | 11 | 0 | 0 |
| Schweißstrom 200 A | 8 | 8 | 7 | 4 |
| Schweißstrom 240 A | 0 | 9 | 7 | 11 |
| Vorschub 30 cm/min | 9 | 11 | 2 | 5 |
| Vorschub 45 cm/min | 7 | 9 | 6 | 5 |
| Vorschub 60 cm/min | 8 | 8 | 6 | 5 |
| Schutzgasmenge 8 l/min | 6 | 10 | 3 | 8 |
| Schutzgasmenge 14 l/min | 8 | 8 | 5 | 6 |
| Schutzgasmenge 20 l/min | 10 | 10 | 6 | 1 |
Bei den Spritzern dominiert der Strom: Bei 160 A gibt es nie mehr als wenige, bei 240 A keine einzige Probe ohne Spritzer und in zwei Dritteln mäßig oder viele. Wenig Schutzgas macht den Lichtbogen unruhiger.
Alle 81 Proben
| Probe | Schweißstrom [A] | Vorschub [cm/min] | Schutzgasmenge [l/min] | Spritzer | Nahtfehler |
|---|---|---|---|---|---|
| 1 | 200 | 60 | 14 | mäßig | Bindefehler |
| 2 | 240 | 30 | 14 | viele | Einbrandkerbe |
| 3 | 240 | 60 | 14 | viele | Einbrandkerbe |
| 4 | 240 | 45 | 8 | viele | Poren |
| 5 | 240 | 60 | 20 | mäßig | Einbrandkerbe |
| 6 | 160 | 30 | 14 | wenige | keiner |
| 7 | 160 | 60 | 20 | wenige | Bindefehler |
| 8 | 240 | 45 | 8 | wenige | Einbrandkerbe |
| 9 | 200 | 30 | 8 | wenige | Poren |
| 10 | 240 | 60 | 8 | viele | Einbrandkerbe |
| 11 | 240 | 45 | 8 | viele | Poren |
| 12 | 160 | 60 | 14 | keine | Bindefehler |
| 13 | 160 | 30 | 20 | keine | keiner |
| 14 | 200 | 60 | 8 | keine | Poren |
| 15 | 160 | 60 | 8 | keine | Bindefehler |
| 16 | 160 | 30 | 8 | keine | keiner |
| 17 | 160 | 30 | 20 | keine | keiner |
| 18 | 240 | 30 | 8 | viele | keiner |
| 19 | 160 | 60 | 14 | keine | Bindefehler |
| 20 | 240 | 30 | 20 | wenige | keiner |
| 21 | 160 | 60 | 20 | keine | Bindefehler |
| 22 | 160 | 45 | 8 | wenige | Bindefehler |
| 23 | 200 | 60 | 14 | keine | keiner |
| 24 | 240 | 60 | 20 | wenige | Einbrandkerbe |
| 25 | 160 | 45 | 20 | keine | keiner |
| 26 | 240 | 60 | 14 | wenige | Einbrandkerbe |
| 27 | 200 | 45 | 20 | viele | Bindefehler |
| 28 | 160 | 45 | 14 | keine | Bindefehler |
| 29 | 200 | 30 | 8 | wenige | Poren |
| 30 | 240 | 60 | 20 | mäßig | Einbrandkerbe |
| 31 | 200 | 60 | 20 | wenige | keiner |
| 32 | 160 | 45 | 14 | keine | Bindefehler |
| 33 | 240 | 45 | 14 | wenige | Einbrandkerbe |
| 34 | 200 | 30 | 14 | wenige | keiner |
| 35 | 240 | 60 | 14 | viele | keiner |
| 36 | 240 | 60 | 8 | viele | Einbrandkerbe |
| 37 | 240 | 45 | 20 | wenige | Poren |
| 38 | 240 | 45 | 20 | mäßig | keiner |
| 39 | 160 | 60 | 20 | wenige | keiner |
| 40 | 160 | 30 | 8 | keine | keiner |
| 41 | 160 | 30 | 14 | keine | Poren |
| 42 | 160 | 45 | 20 | keine | keiner |
| 43 | 200 | 30 | 20 | wenige | Einbrandkerbe |
| 44 | 200 | 45 | 14 | keine | Einbrandkerbe |
| 45 | 200 | 45 | 14 | mäßig | keiner |
| 46 | 240 | 30 | 20 | wenige | keiner |
| 47 | 200 | 45 | 20 | mäßig | Bindefehler |
| 48 | 240 | 45 | 20 | mäßig | Einbrandkerbe |
| 49 | 160 | 60 | 14 | keine | Bindefehler |
| 50 | 240 | 45 | 14 | viele | keiner |
| 51 | 160 | 45 | 8 | wenige | Bindefehler |
| 52 | 240 | 45 | 14 | mäßig | Einbrandkerbe |
| 53 | 160 | 45 | 8 | keine | keiner |
| 54 | 200 | 30 | 8 | keine | Poren |
| 55 | 200 | 45 | 8 | wenige | keiner |
| 56 | 240 | 30 | 20 | mäßig | keiner |
| 57 | 160 | 30 | 8 | wenige | Poren |
| 58 | 160 | 60 | 8 | wenige | Poren |
| 59 | 200 | 30 | 20 | keine | keiner |
| 60 | 200 | 45 | 20 | keine | keiner |
| 61 | 200 | 45 | 14 | wenige | keiner |
| 62 | 200 | 60 | 8 | viele | Bindefehler |
| 63 | 200 | 60 | 8 | mäßig | Bindefehler |
| 64 | 240 | 30 | 14 | viele | keiner |
| 65 | 200 | 30 | 14 | mäßig | keiner |
| 66 | 240 | 30 | 8 | wenige | keiner |
| 67 | 240 | 30 | 14 | wenige | Poren |
| 68 | 200 | 60 | 20 | wenige | keiner |
| 69 | 160 | 45 | 14 | wenige | keiner |
| 70 | 200 | 30 | 14 | viele | keiner |
| 71 | 160 | 30 | 14 | wenige | Poren |
| 72 | 160 | 45 | 20 | wenige | Bindefehler |
| 73 | 160 | 30 | 20 | keine | Bindefehler |
| 74 | 160 | 60 | 8 | wenige | Bindefehler |
| 75 | 200 | 60 | 20 | keine | Bindefehler |
| 76 | 240 | 60 | 8 | mäßig | keiner |
| 77 | 200 | 60 | 14 | mäßig | Bindefehler |
| 78 | 200 | 45 | 8 | mäßig | keiner |
| 79 | 200 | 45 | 8 | viele | keiner |
| 80 | 240 | 30 | 8 | viele | Poren |
| 81 | 200 | 30 | 20 | keine | keiner |
Schritt 4 / Spritzer
Geordnete Stufen: das Modell der proportionalen Odds
Für eine geordnete Zielgröße wählt DoEStat das kumulative Logit-Modell: Es beschreibt die Wahrscheinlichkeit, höchstens eine bestimmte Stufe zu erreichen. Man kann es sich so vorstellen, dass hinter den vier Stufen eine unsichtbare Spritzneigung steht, die von den Faktoren verschoben wird; drei Schwellen teilen sie in die Stufen ein. Jeder Faktor bekommt eine Steigung, die für alle drei Schwellen gilt — daher „proportionale Odds“.
| Term | Schätzung | Standardfehler | z | p-Wert | Wahrer Wert |
|---|---|---|---|---|---|
| Schweißstrom | 1,88 | 0,33 | 5,73 | < 0,0001 | 1,50 |
| Vorschub | 0,26 | 0,27 | 0,97 | 0,3342 | 0,30 |
| Schutzgasmenge | −0,72 | 0,27 | −2,63 | 0,0085 | −0,80 |
Eine positive Steigung schiebt die Naht zu mehr Spritzern. Der Strom wirkt stark (z = 5,7), das Schutzgas dämpft (p = 0,008), der Vorschub ist nicht nachweisbar (p = 0,33). Die Spalte „Wahrer Wert“ ist der Vergleich mit dem Modell, aus dem die Daten stammen — der Strom wird etwas überschätzt, Richtung und Rangfolge stimmen.
| Schwelle | Schätzung | Standardfehler | Wahrer Wert |
|---|---|---|---|
| keine | wenige | −1,39 | 0,32 | −1,00 |
| wenige | mäßig | 0,89 | 0,29 | 0,80 |
| mäßig | viele | 2,18 | 0,37 | 2,40 |
Trägt die Annahme gleicher Steigungen?
Das Modell behauptet, ein Faktor wirke an jeder Schwelle gleich stark. Ob die Daten das hergeben, prüft der Brant-Test: Er schätzt die drei Schwellen getrennt und vergleicht die Steigungen. Ein kleiner p-Wert hieße, dass ein Faktor etwa zwischen „keine“ und „wenige“ anders wirkt als zwischen „mäßig“ und „viele“ — dann wäre das multinomiale Modell die ehrlichere Wahl.
| Term | χ² | FG | p-Wert |
|---|---|---|---|
| Schweißstrom | 0,03 | 2 | 0,9836 |
| Vorschub | 2,07 | 2 | 0,3543 |
| Schutzgasmenge | 2,70 | 2 | 0,2594 |
| Gesamt (Omnibus) | 5,19 | 6 | 0,5198 |
Kein Faktor widerspricht (gemeinsam p = 0,52). Das ordinale Modell darf bleiben — und es braucht für drei Faktoren drei Steigungen statt neun.
| Log-Likelihood | ohne Faktoren | Likelihood-Quotienten-Test χ² (FG) | p-Wert | McFadden-R² | AIC |
|---|---|---|---|---|---|
| −85,8 | −108,8 | 45,9 (3) | < 0,0001 | 0,211 | 183,7 |
| beobachtet ↓ / vorhergesagt → | keine | wenige | mäßig | viele | Treffer |
|---|---|---|---|---|---|
| keine | 15 | 9 | 0 | 0 | 15 / 24 |
| wenige | 9 | 13 | 0 | 6 | 13 / 28 |
| mäßig | 0 | 10 | 0 | 4 | 0 / 14 |
| viele | 0 | 4 | 0 | 11 | 11 / 15 |
| Trefferquote | 48 % |
Die Wahrheitsmatrix vergleicht die beobachtete Stufe mit der wahrscheinlichsten Stufe laut Modell. 48 % Treffer klingen wenig, sind aber das Wesen einer Wahrscheinlichkeit: Bei einer Einstellung mit 45 % „wenige“ und 35 % „keine“ ist „wenige“ die beste Vorhersage und trotzdem oft falsch. „Mäßig“ ist nie die wahrscheinlichste Stufe — sie liegt zwischen zwei Nachbarn, die jeweils häufiger sind. Was das Modell zuverlässig trennt, sind die Enden: Keine Probe mit „keinen“ Spritzern wird als „mäßig“ oder „viele“ vorhergesagt, und umgekehrt.
Schritt 5 / Nahtfehler
Benannte Kategorien: das multinomiale Logit
Ohne Reihenfolge gibt es keine gemeinsame Skala. Das multinomiale Logit vergleicht deshalb jeden Fehler einzeln mit einer Bezugskategorie — hier „keiner“ — und gibt jedem Fehler eigene Steigungen. So darf der Strom Bindefehler verhindern und zugleich Einbrandkerben verursachen, ohne dass sich das gegenseitig aufhebt.
| Klasse gegen „keiner“ | Term | Schätzung | Standardfehler | p-Wert | Wahrer Wert |
|---|---|---|---|---|---|
| Poren | Achsenabschnitt | −1,52 | 0,50 | 0,0021 | −1,20 |
| Poren | Schweißstrom | 0,15 | 0,47 | 0,7435 | 0,00 |
| Poren | Vorschub | −0,47 | 0,51 | 0,3566 | 0,00 |
| Poren | Schutzgasmenge | −1,42 | 0,53 | 0,0075 | −1,60 |
| Bindefehler | Achsenabschnitt | −1,45 | 0,51 | 0,0044 | −1,10 |
| Bindefehler | Schweißstrom | −1,75 | 0,62 | 0,0045 | −2,00 |
| Bindefehler | Vorschub | 1,78 | 0,53 | 0,0009 | 1,50 |
| Bindefehler | Schutzgasmenge | −0,04 | 0,44 | 0,9301 | 0,00 |
| Einbrandkerbe | Achsenabschnitt | −2,20 | 0,75 | 0,0032 | −1,70 |
| Einbrandkerbe | Schweißstrom | 2,35 | 0,83 | 0,0046 | 1,80 |
| Einbrandkerbe | Vorschub | 1,05 | 0,51 | 0,0394 | 1,20 |
| Einbrandkerbe | Schutzgasmenge | 0,13 | 0,49 | 0,7863 | 0,00 |
Jeder Fehler hat seine eigene Ursache, und die Auswertung findet sie: Poren am Schutzgas (−1,42, wahr −1,6), Bindefehler an wenig Strom und schnellem Vorschub, Einbrandkerben an viel Strom und — schwächer — schnellem Vorschub. Alle Terme, die im wahren Modell null sind, bleiben unauffällig (p > 0,3).
| Log-Likelihood | ohne Faktoren | Likelihood-Quotienten-Test χ² (FG) | p-Wert | McFadden-R² | AIC |
|---|---|---|---|---|---|
| −71,2 | −105,8 | 69,3 (9) | < 0,0001 | 0,327 | 166,4 |
| beobachtet ↓ / vorhergesagt → | keiner | Poren | Bindefehler | Einbrandkerbe | Treffer |
|---|---|---|---|---|---|
| keiner | 18 | 4 | 8 | 4 | 18 / 34 |
| Poren | 3 | 7 | 2 | 1 | 7 / 13 |
| Bindefehler | 3 | 0 | 17 | 0 | 17 / 20 |
| Einbrandkerbe | 3 | 1 | 0 | 10 | 10 / 14 |
| Trefferquote | 64 % |
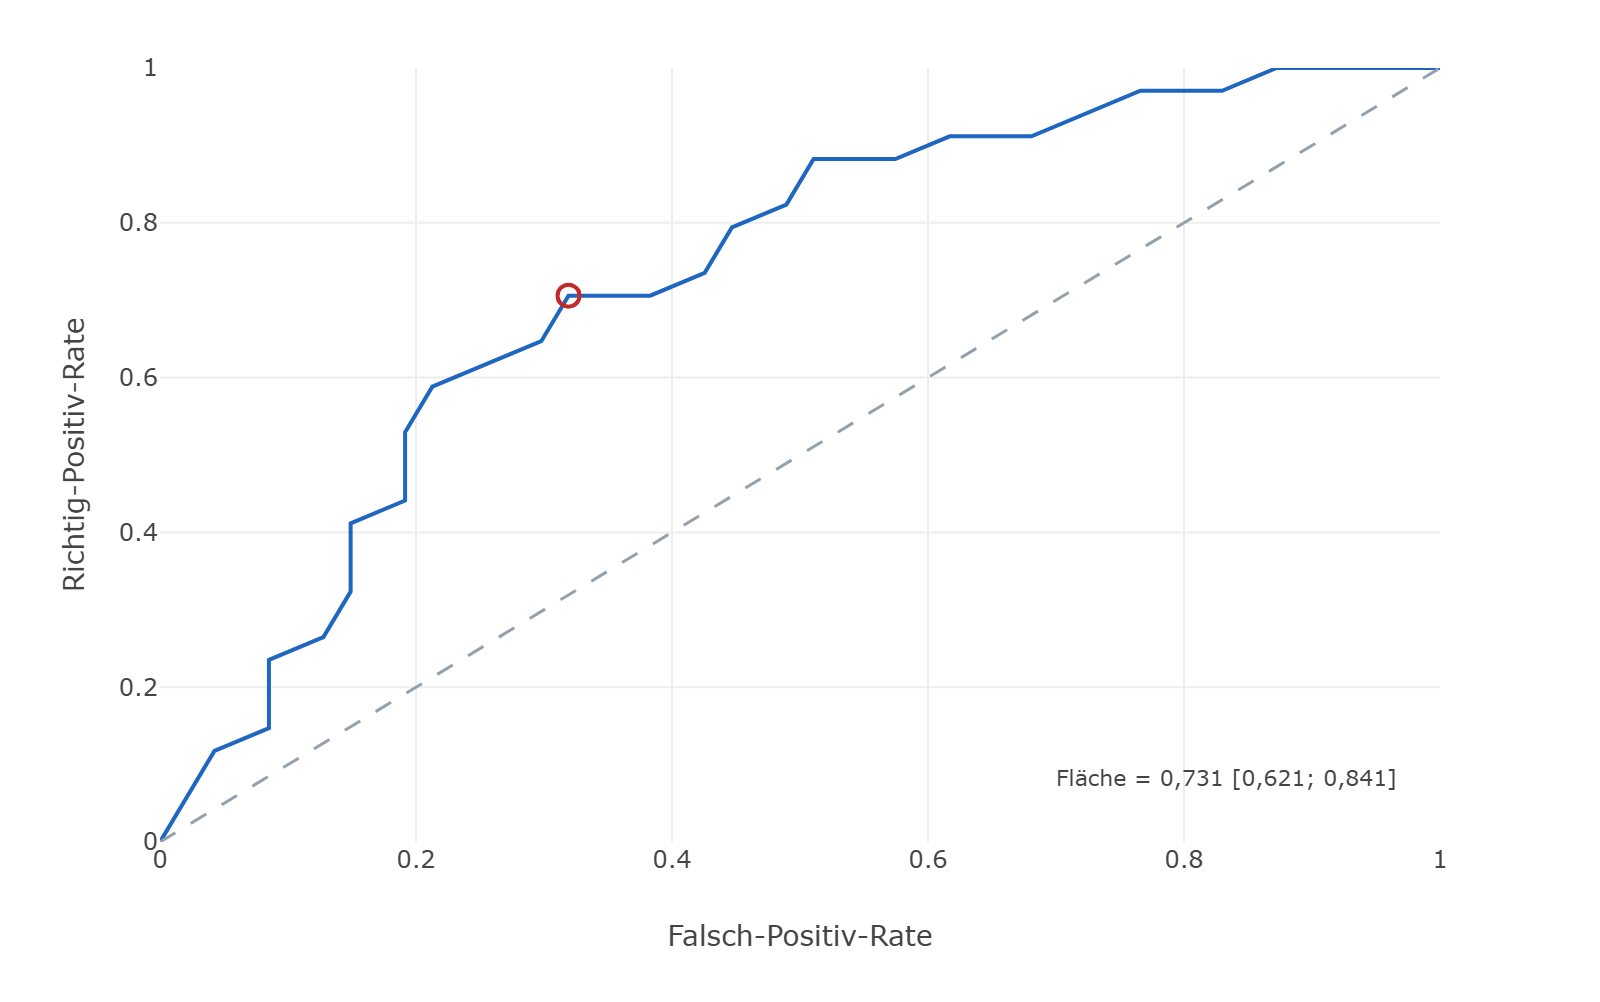
Bindefehler und Einbrandkerben erkennt das Modell am besten — sie haben klare, gegenläufige Ursachen. Am schwersten ist die fehlerfreie Naht vorherzusagen: Sie ist das, was übrig bleibt, wenn keiner der drei Fehler auftritt, und hat damit keine eigene Ursache.
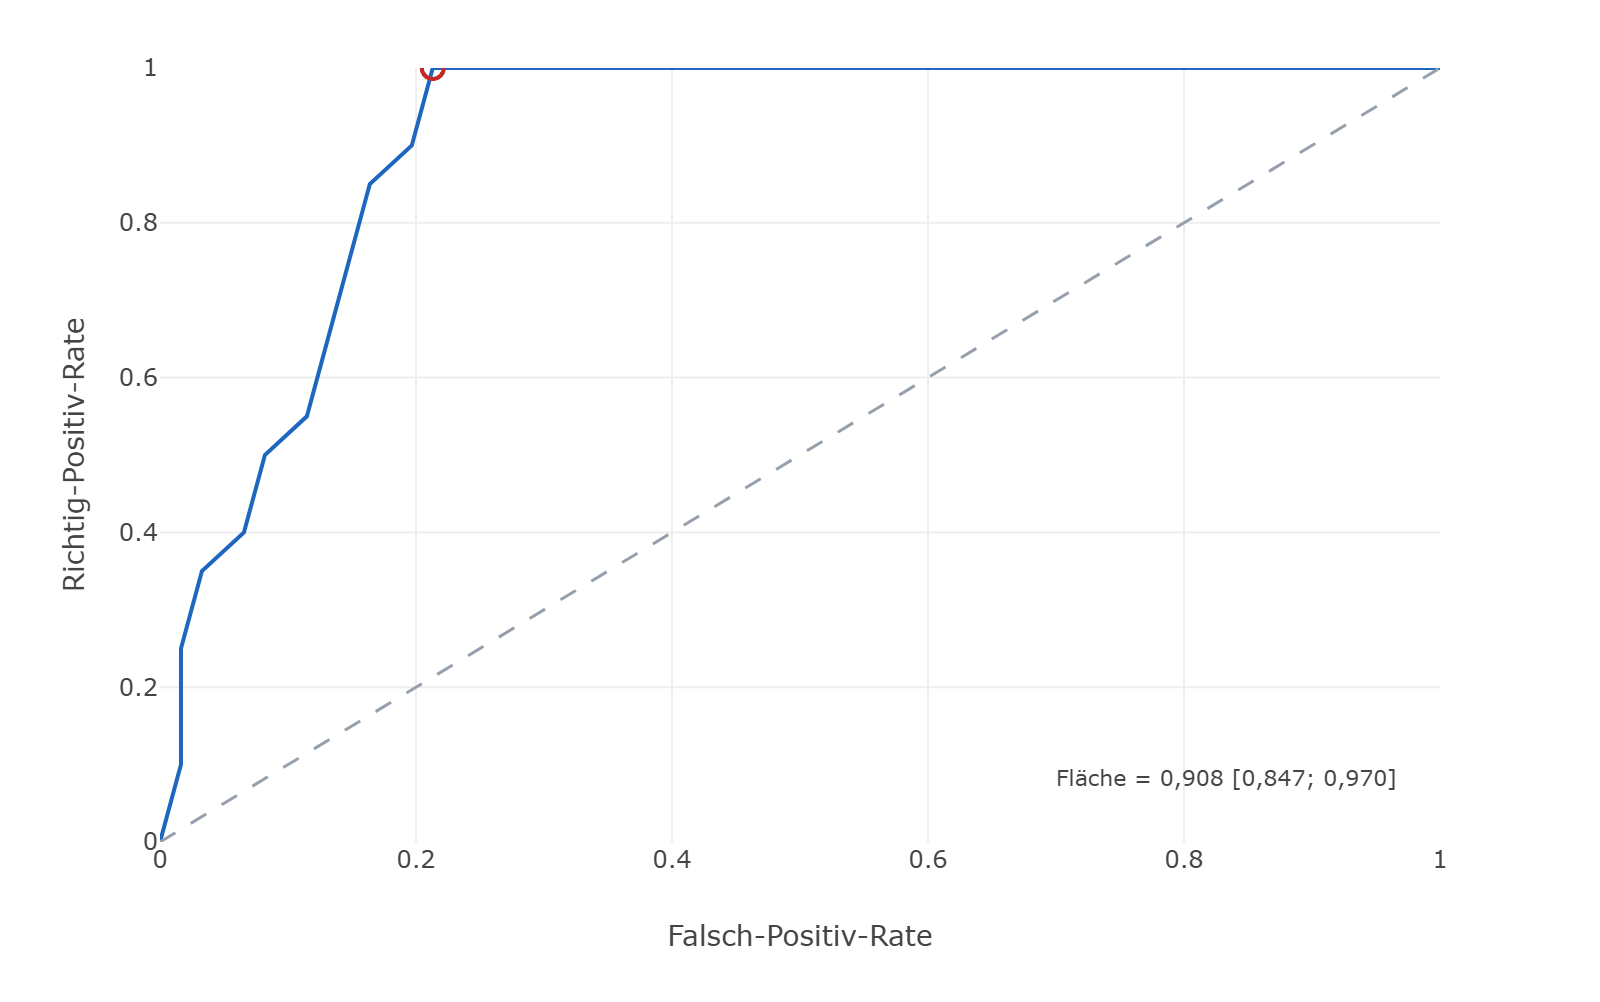
| Klasse | Anzahl | AUC | 95-%-Intervall |
|---|---|---|---|
| keiner | 34 | 0,731 | 0,621 … 0,841 |
| Poren | 13 | 0,799 | 0,660 … 0,938 |
| Bindefehler | 20 | 0,908 | 0,847 … 0,970 |
| Einbrandkerbe | 14 | 0,900 | 0,810 … 0,989 |
Dasselbe zeigen die ROC-Kurven, die DoEStat für jede Kategorie gegen alle anderen zeichnet: Die Fläche unter der Kurve ist für Bindefehler 0,91, für die fehlerfreie Naht 0,73.
Schritt 6 / Prozessfenster
Wo eine gute Naht am wahrscheinlichsten ist
Der Wahrscheinlichkeits-Profiler zeigt für jede Kategorie, wie sich ihre Wahrscheinlichkeit ändert, wenn man einen Faktor verschiebt und die anderen festhält. Die vier Kurven einer Spalte addieren sich überall zu eins. In DoEStat zieht man die Linien mit der Maus und sieht beide Zielgrößen zugleich.
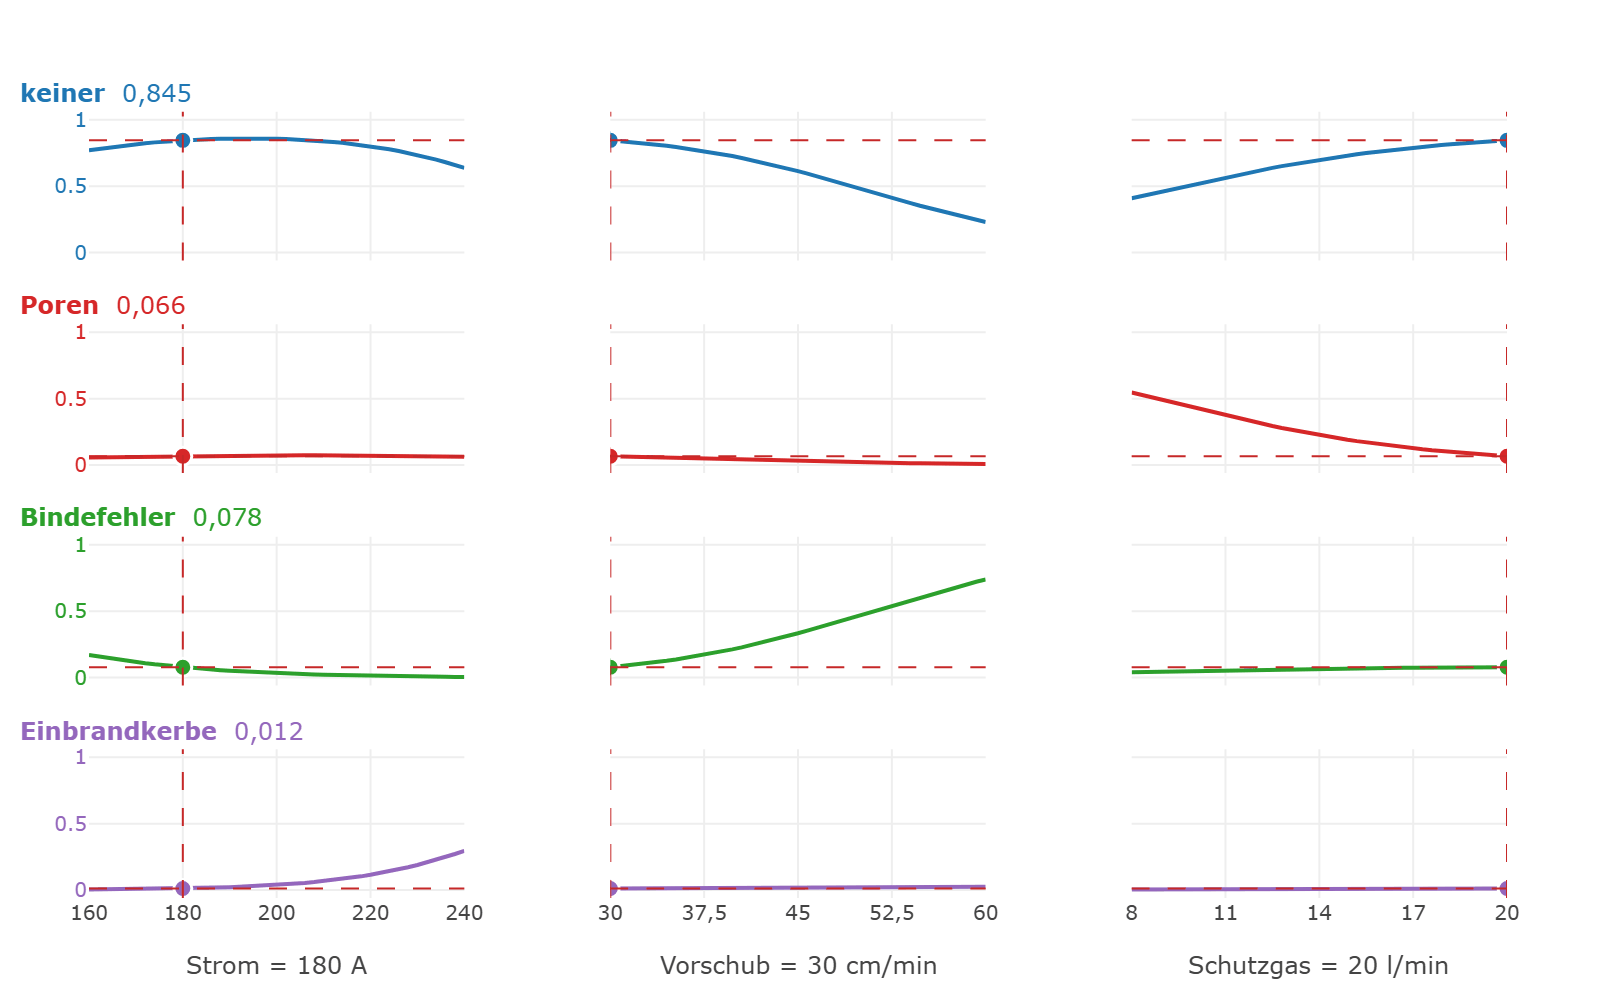
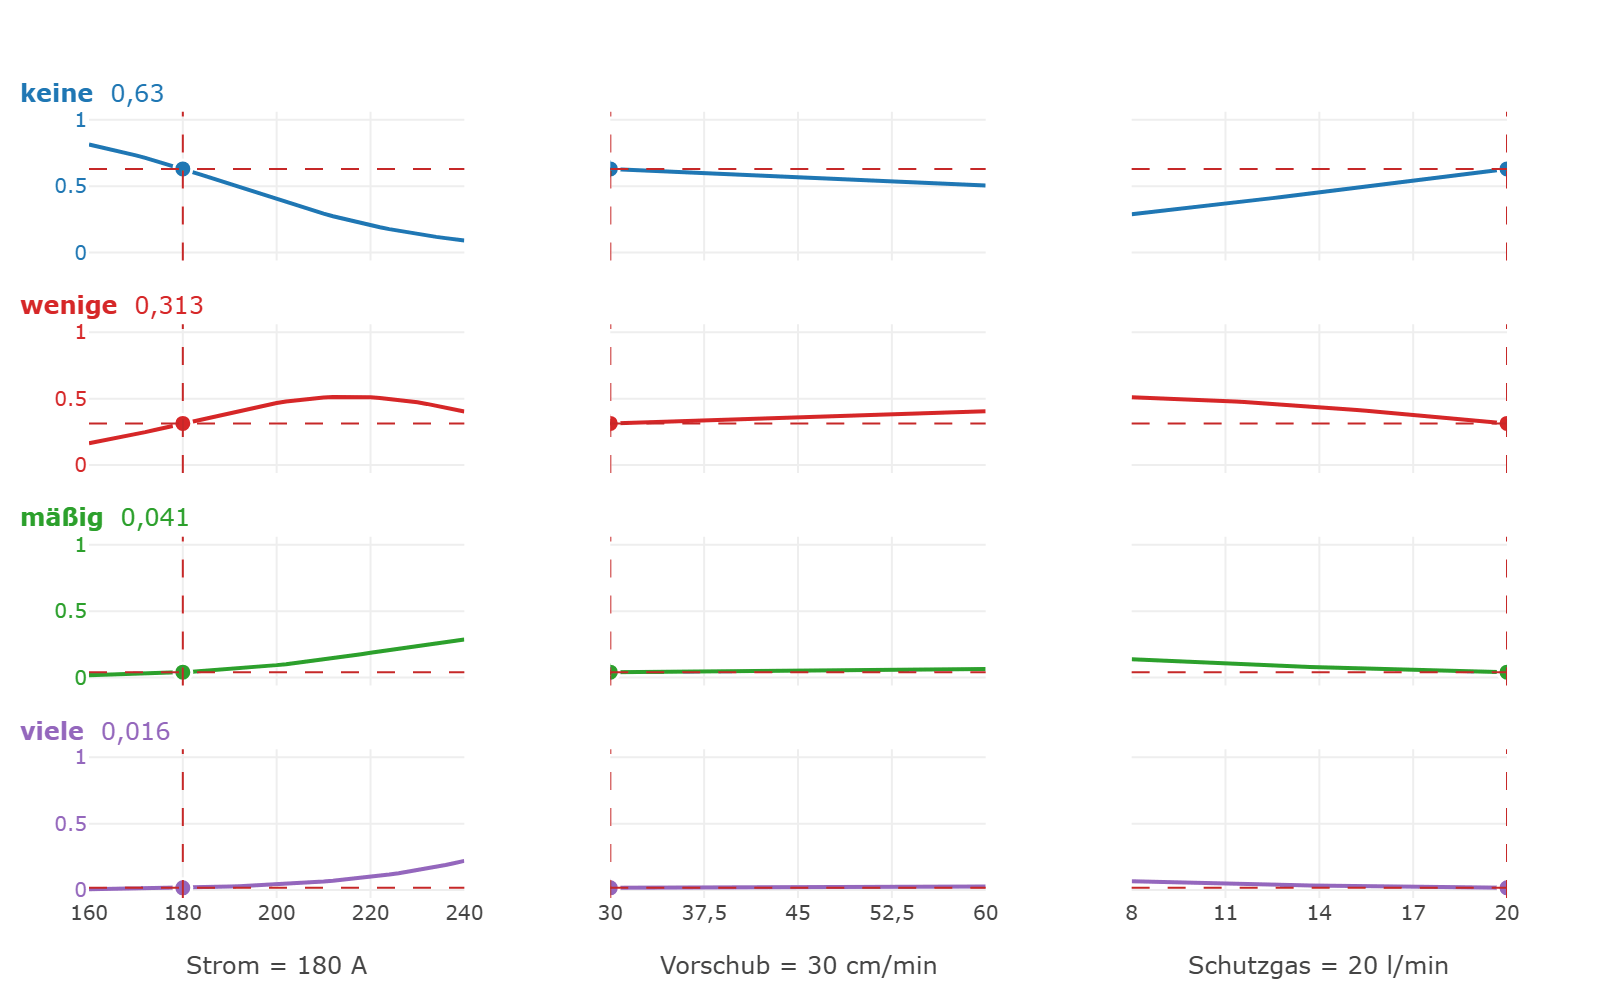
Die Profiler stehen an der Einstellung, bei der eine gute Probe — kein Nahtfehler, höchstens wenige Spritzer — am wahrscheinlichsten ist. Gesucht wurde sie als Produkt der beiden Wahrscheinlichkeiten über ein Gitter des Versuchsraums:
| Faktor | Einstellung | Einheit | kodiert |
|---|---|---|---|
| Schweißstrom | 180 | A | −0,50 |
| Vorschub | 30 | cm/min | −1,00 |
| Schutzgasmenge | 20 | l/min | 1,00 |
Der Strom liegt im unteren Viertel des Bereichs: Mehr Strom bringt Spritzer und Einbrandkerben, weniger bringt Bindefehler. Vorschub und Schutzgas stehen am Rand des Versuchsraums — langsam schweißen und reichlich Gas sind hier schlicht besser. Wer jenseits davon sucht, verlässt den untersuchten Bereich; das Modell weiß dort nichts.
Schritt 7 / Bestätigung
24 Proben an der gewählten Einstellung
Eine Wahrscheinlichkeit bestätigt man nicht mit einer Probe. An der gewählten Einstellung werden 24 Proben geschweißt und beurteilt wie in der Studie:
| Zielgröße | Kategorie | Vorhersage des Modells | Wahre Wahrscheinlichkeit | Bestätigung (24 Proben) |
|---|---|---|---|---|
| Spritzer | keine | 63 % | 70 % | 18 |
| wenige | 31 % | 23 % | 5 | |
| mäßig | 4 % | 5 % | 1 | |
| viele | 2 % | 1 % | 0 | |
| Nahtfehler | keiner | 84 % | 78 % | 19 |
| Poren | 7 % | 5 % | 2 | |
| Bindefehler | 8 % | 16 % | 3 | |
| Einbrandkerbe | 1 % | 2 % | 0 |
Ergebnis: 18 der 24 Proben sind gut (75 %) — in der Studie waren es 22 von 81 (27 %). Das Modell hatte 80 % versprochen; wahr sind 73 %. Die Lücke ist typisch: Wer unter allen Einstellungen die beste aussucht, sucht auch die aus, bei der das Modell zufällig zu optimistisch ist. Am deutlichsten bei den Bindefehlern — das Modell erwartet 8 %, wahr sind 16 %, beobachtet wurden 3 von 24.
Bilanz
Was die richtige Skala gebracht hat
Zwei Zielgrößen, die sich nicht messen, nur einstufen lassen, und für jede das Modell, das zu ihrer Art passt. Das ordinale Modell nutzt die Reihenfolge der Spritzerstufen und kommt mit drei Steigungen aus; der Brant-Test hat bestätigt, dass das genügt. Das multinomiale Modell lässt jedem Nahtfehler seine eigene Ursache — und genau das war nötig, denn der Strom verhindert den einen Fehler und verursacht den anderen.
Der Preis ist die Probenzahl. Kategoriale Daten brauchen Wiederholungen, und das nominale Modell braucht mehr als das ordinale. Die Planungsrechnung vorab hat gezeigt, dass 54 Proben in einer von fünf Studien zu keinem brauchbaren Ergebnis geführt hätten, und dass ein naheliegender quadratischer Term die Sache verschlimmert.
Gegen die Wahrheit: Alle Faktoren, die im wahren Modell wirken, sind gefunden, mit richtigem Vorzeichen; alle, die nicht wirken, sind unauffällig. Die Schätzungen weichen um bis zu gut ein halbes Logit von der Wahrheit ab — bei 81 Proben mit je einem Urteil ist das die Genauigkeit, die man erwarten kann. Und die Bestätigung zeigt, dass die Wahrscheinlichkeit an der besten Einstellung etwas überschätzt wird: Wer eine Zusage machen muss, nimmt das Ergebnis der Bestätigungsproben, nicht die Vorhersage.
Projektdateien
Selbst nachfahren
Das Beispiel liegt DoEStat als Projekt bei: Hilfe ▸ Beispielprojekt öffnen ▸ Sonstiges ▸ „Kategoriale Zielgrößen: Schweißnaht“, einmal nur mit den Daten (mit dem vollen quadratischen Modell, für das ein Plan mit drei Stufen gemacht ist) und einmal mit fertiger Auswertung (Haupteffekte). Dieselben Dateien gibt es hier zum Herunterladen.
- Projekt mit den Datenschweissnaht-kategorial-daten.doejson
- Projekt mit fertiger Auswertungschweissnaht-kategorial-auswertung.doejson
DoEStat kostenlos testen
30 Tage, voller Funktionsumfang, kein Zahlungsmittel. Den Download-Link senden wir per E-Mail, in der Regel am nächsten Werktag.